
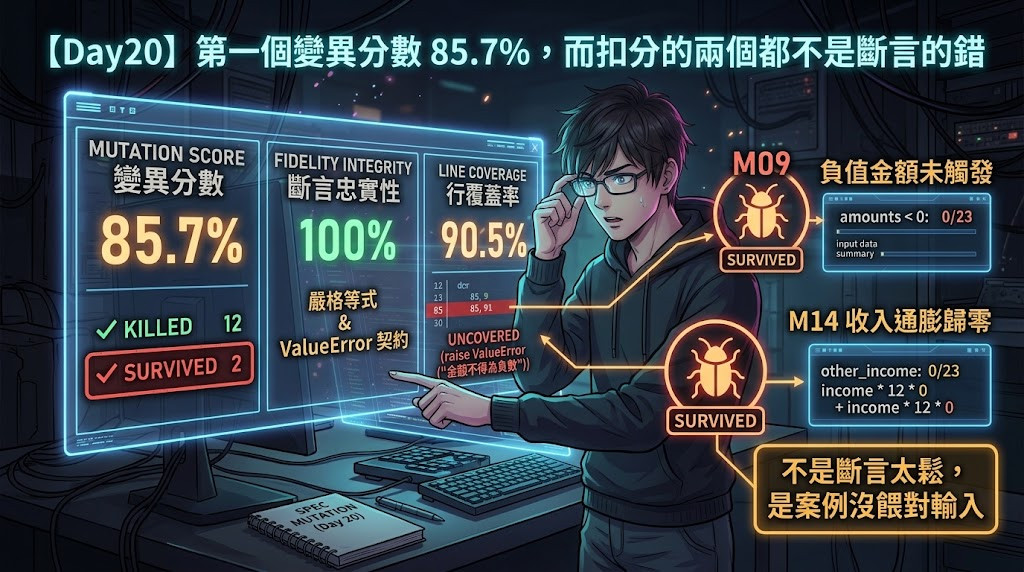
calc_fixed.py,golden v2 套件殺掉十二個,變異分數 85.7%
M09、M14 都不是「斷言不夠嚴」,是案例沒餵那個輸入
四天的工具在今天收斂:斷言檢核器、覆蓋率探針、過了五題校準的變異引擎,加上十四個帶著證據等級的變異體。
今天把三把尺同時架在同一套測試上,看它們各自說什麼。分數多少,跑完才知道。預期寫在 manifest.yaml 裡,跑之前就封存了。
基底 shadow/calc_fixed.py,應戰的是 tests/test_golden_v2.py(23 組案例,21 組把數值鎖到 rel_tol = 1e-12,2 組要求拋 ValueError)。
基準線:未變異時 tests/test_golden_v2.py 全綠

  ✓ 殺掉 M01  折現指數 idx → idx + 1
  ✓ 殺掉 M02  餘額軌跡加回 max(0.0, ...)
  ✓ 殺掉 M03  名目月利率 → 有效月利率
  ✓ 殺掉 M04  本金退回年複利
  ✓ 殺掉 M05  移除淨支出截斷
  ✓ 殺掉 M06  提領期上界含大筆支出年齡
  ✓ 殺掉 M07  大筆支出配對 == → >=
  ✓ 殺掉 M08  移除年齡順序校驗
  ✗ 存活 M09  移除金額負值校驗
  ✓ 殺掉 M10  通膨基準年 −1
  ✓ 殺掉 M11  提領首年誤用退休前報酬率
  ✓ 殺掉 M12  起領年齡 >= → >
  ✓ 殺掉 M13  大筆支出不計通膨
  ✗ 存活 M14  退休後收入不隨通膨調升

殺掉 12 / 計分 14(ERROR 0、等價 0)
變異分數 = 85.7%
沒有無效變異體,沒有等價變異體,分母乾乾淨淨就是 14。
這個分數本身沒什麼好說的。先把另外兩把尺也架上去,存活的那兩個為什麼活著,答案會自己浮出來。
同一套 test_golden_v2.py:
| 量什麼 | 結果 |
|---|---|
| 斷言忠實性(Day 16 檢核器) | 100%,5 條精確斷言 + 1 條 pytest.raises 契約,閘門 3 PASS |
| 行覆蓋率(Day 17 探針) | 90.5%,42 行邏輯走過 38 行 |
| 變異分數(今天) | 85.7% |
三個數字,三個不同的視角。而它們指向的不是同一批問題。
先看覆蓋率漏掉的那四行是什麼:
未覆蓋:73, 85, 89, 91

  73  raise ValueError("請領年齡不得為負數")
  85  raise ValueError("金額不得為負數")
  89  raise ValueError("大筆支出年齡不得為負數")
  91  raise ValueError("大筆支出金額不得為負數")
四行全部是「不得為負數」的 raise。 那 9.5% 不是散落各處的邊角,是一整類校驗從來沒有被觸發過。
打開 golden_set_v2.json 數輸入,答案立刻出來:
| 檢查 | 結果 |
|---|---|
| 含負值輸入的案例 | 0 / 23 |
other_income 非零的案例 |
0 / 23 |
那兩組「預期被拒」的案例是 def_b_inverted(壽命 60 < 退休 65)與 def_b_equal(壽命 = 退休年齡),都是年齡順序違規,不是金額違規。所以 M09 拿掉的那段檢查,23 組裡沒有任何一組會踩到。
第 84 行的條件 if any(amt < 0 for amt in amounts) 有被執行,每次都是 False;第 85 行的 raise 一次都沒跑到。覆蓋率報表會把第 85 行標成紅的。
M14 是另一種處境。那一行是:
total_income += p.other_income * 12 * ((1.0 + p.inflation_rate) ** (t - p.current_age))
第 129 行在覆蓋率報表上是綠的:23 組每一組都走過它。但 other_income 全部是 0,0 × 12 × (1+i)^k 與 0 × 12 恆等,拿掉通膨那一項,數字一位都不會動。
所以兩個存活的,剛好是覆蓋率的兩種處境:
| 覆蓋率看得到嗎 | 為什麼殺不掉 | |
|---|---|---|
M09 |
看得到,第 85 行是紅的 | 那條路徑從來沒走過 |
M14 |
看不到,第 129 行是綠的 | 走過了,但乘數是 0 |
M09 那個洞,覆蓋率早就在報表上舉手了,只是沒有人去看那份報表。而 M14 那個洞,覆蓋率永遠不會舉手。
Day 17 的結論是「行被執行過,不等於邏輯被檢驗過」。當時那是推論:覆蓋率滿分,變異體依然大量存活。今天 M14 是它的實證:第 129 行綠得漂亮,而改壞它沒有任何一組會紅。
要讓一行程式碼真的被檢驗,需要三件事同時成立:
M09 卡在第一步,M14 卡在第二步。而忠實性 100% 證明第三步做得很好:它只是沒有機會發揮。
兩個存活的都不是被弱斷言放過的,是被輸入放過的。
五個欄位一起數完:
| 欄位 | 非零案例 |
|---|---|
other_income |
0 / 23 |
annual_recurring_expense |
0 / 23 |
labor_pension_monthly |
1 / 23 |
labor_insurance_pension |
4 / 23 |
lump_sums |
6 / 23 |
第二列的 annual_recurring_expense 是 PRD-08 的固定年支出,Day 14 列的三條待補測試之一:那天寫下「會在分流之後一起寫」,六天過去,它還是 0 / 23。
這五列解釋了今天分數的組成,而且分界線異常乾淨:殺掉的十二個,改的路徑都至少有案例踩得到(折現與複利每一組都走,大筆支出有 6 組,勞保有 4 組,年齡校驗有 2 組非法輸入);存活的兩個,改的路徑是零組。
現在往 golden set 塞兩組案例:一組負值金額、一組非零其他收入,分數會立刻變 100%。
我不打算這樣做,理由有三個。
「跑之前定,跑完不改」。 補完之後的 100% 是我為了好看調出來的,不是量出來的。
存活的變異體是產出,不是故障。 變異測試的功能就是指出盲區。M09 與 M14 存活,意思是「這套測試從來沒餵過負值金額,也沒餵過非零的其他收入」,這正是花四天蓋工具想知道的事。把它修掉再宣布分數,等於摔了體溫計再說自己沒發燒。
golden set 的角色被搞混了。 它是「鎖住正確行為的快照」,不是「涵蓋所有輸入的測試設計」。要補這兩個洞,正確做法可能是另外寫針對性的測試,不是往快照裡塞案例。那是設計決定,該經過裁決,不該順手做。
所以今天的處置是記錄:兩個存活的都判為真漏洞、非等價,連同輸入空間那五列一起進 manifest.yaml。
manifest.yaml 裡那欄 expectations 不是我寫的,是 Claude 寫的。跑之前封存,跑完不改。
| 它的預測 | 實際 |
|---|---|
M07、M11、M12 存活 |
全部被殺 |
M14 被殺 |
存活 |
M06 可能等價、M09 會被抓到 |
一個被殺、一個存活 |
十四個變異體,六個猜對、六個猜錯、兩個沒作答。
我把結果貼回去問它。它答得很漂亮:「我只看了變異體,沒看案例」,存活與否是改動與輸入共同決定,而它只算了一邊。承認得乾脆,但只挑兩個錯的認,另外四個隻字未提。接著在同一段寫下:
為什麼這樣還對了十二個⋯⋯
十二是被殺的變異體數量,不是它猜對的題數。它把受測物的成績抄成了自己的成績。
推理通順,認錯誠懇,甚至把盲區畫成表格,但它連自己錯了幾題都算不對。要接住這種錯,只能把預測封存,跑完親自對帳。那張對帳表是人做的。
這個 85.7% 不能拿來做什麼
它是「這套測試守得住我設計的十四種錯法裡的幾種」,不是「這套測試有多好」。分母換一份目錄,分數就換一個。
十四個變異體是我設計的,golden set 的 23 組是我定的,兩邊的盲區重疊:other_income 沒有變異體以外的測試看著,也沒有案例餵過它。這個分數量不到「我和 AI 都沒想到的那一類錯」。
單次量測,沒有分佈。今天沒有重跑的必要(變異注入是確定性的),但換一份測試套件、換一個基底,這個數字沒有可比性。
環境:Python 3.14.5、pytest 9.1.1。回傳碼的語意跟 pytest 大版本綁定,換版本要重新校準引擎。
只帶走一件事
一個變異體活下來,可能是斷言太鬆,也可能是那段程式碼從來沒被餵過會讓它出錯的值。
前者改測試,後者改案例,而分數不會告訴你是哪一種,得自己去驗屍。
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day20


 iThome鐵人賽
 看影片追技術